C++ STL 算法详解
Categories: C++
算法把迭代器作为中介从而间接操作容器中的元素,而不直接操作容器本身。所有标准库算法都实现为函数模板的形式,其中模板类型参数一般都是迭代器类型。
简单例子
find 和 find_if
find() 在某个迭代器范围内查找特定元素。可将其用于任意容器类型。这个算法返回所找到元素的迭代器,如果没有找到元素,则返回迭代器范围的尾迭代器。
注意:如果 find() 没有找到元素,那么返回的迭代器等于函数调用中指定的尾迭代器,而不是底层容器的尾迭代器。
auto endIt = cend(myVector);
auto it = find(cbegin(myVector), endIt, num);
// it == endIt -> not find

// C++17
if (auto it = find(cbegin(myVector), endIt, num); it == endIt) {
    // not find
}
一些容器(例如 map 和 set)以类方法的方式提供自己的 find() 函数。如果容器提供的方法具有与泛型算法同样的功能,那么应该使用容器相应的方法,那样速度更快。比如,泛型算法 find() 的复杂度为线性时间,用于 map 迭代器时也是如此;而 map 中 find() 方法的复杂度是对数时间。
find_if
find_if() 和 find() 类似,区别在于 find_if() 接收谓词函数回调作为参数,而不是简单的匹配元素。谓词返回 true 或 false。find_if() 算法对范围内的每个元素调用谓词,直到谓词返回 true。
find_if(cbegin(myVector), endIt, Pred);accumulate
我们经常需要计算容器中所有元素的总和或其他算术值。accumulate 函数就提供了这种功能,该函数在 <numeric>(而非 <algorithm>)中定义。
// 总和
int sum = accumulate(cbegin(nums), cend(nums), 0);

// 给 accumulate 提供的二元回调。也可以是 lambda
int product(int num1, int num2) {
    return num1 * num2;
}
// 计算乘积
double mult = accumulate(cbegin(nums), cend(nums), 1, product);
std::function
std::function 在 <functional> 头文件中定义,可用来创建指向函数、函数对象或 lambda 表达式的类型;从根本上说可以指向任何可调用的对象。它被称为多态函数包装器,可以当成函数指针使用,还可用作实现回调的函数的参数。
模板定义:
std::function<R(ArgTypes...)>R 是函数返回值的类型,ArgTypes 是一个以逗号分隔的函数参数类型的列表。
std::function 真正有用的场合是将回调作为类的成员变量。在接收函数指针作为自定义函数的参数时,也可以使用 std::function。
// 实现一个函数指针 f1 指向 func
function<void(int, const string&)> f1 = func;
f1(1, "test");
std::function 作为函数形参可以接收任意可调用对象。如果用普通函数指针作为函数参数,lambda 表达式实参作为参数传递给该函数是不行的。
void process(const vector<int>& vec, function<void(int)> f) {
    for (auto& i : vec)
        f(i);
}

void print(int num) {
    cout << num << " ";
}

int main() {
    vector<int> vec{0, 1, 2, 3, 4, 5, 6, 7, 8, 9};
    process(vec, print);
    cout << endl;
    int sum = 0;
    // 如果 process 第二个参数是普通函数指针,传递 lambda 是不行的
    process(vec, [&sum](int num){ sum += num; });
    cout << "sum = " << sum << endl;
    return 0;
}
lambda 表达式
使用 lambda 表达式可编写内嵌的匿名函数,而不必编写独立函数或函数对象,使代码更容易阅读和理解。
语法:
[捕获列表] (参数列表) mutable -> 返回值类型 { 函数体 };- (参数列表):如果没有可省略
- 可以忽略返回类型。如果忽略了返回类型,编译器就根据函数返回类型推断规则来推断 lambda 表达式的返回类型
lambda 表达式的方括号 [] 部分称为 lambda 捕捉块(capture block)。捕捉变量的意思是可在 lambda 表达式体中使用这个变量。
- 指定空白的捕捉块 [] 表示不从所在作用域内捕捉变量
- 在捕捉块中只写出变量名将按值捕捉该变量
- &变量名将按引用捕捉该变量
编译器将 lambda 表达式转换为某种未命名的仿函数(即函数对象)。捕捉的变量变成这个仿函数的数据成员,将按值捕捉的变量复制到仿函数的数据成员中。
仿函数总是实现函数调用运算符 operator()。对于 lambda 表达式,这个函数调用运算符被默认标记为 const,这表示即使在 lambda 表达式中按值捕捉了非 const 变量,lambda 表达式也不能修改其副本。把 lambda 表达式指定为 mutable,就可以把函数调用运算符标记为非 const。
注意:如果指定了 mutable,就必须给参数指定圆括号,即使圆括号为空。
在变量名前面加上 &,就可按引用捕捉它。lambda 表达式可以直接修改按引用捕获的变量。
警告:按引用捕捉变量时,必须确保执行 lambda 表达式时,该引用仍然是有效的。
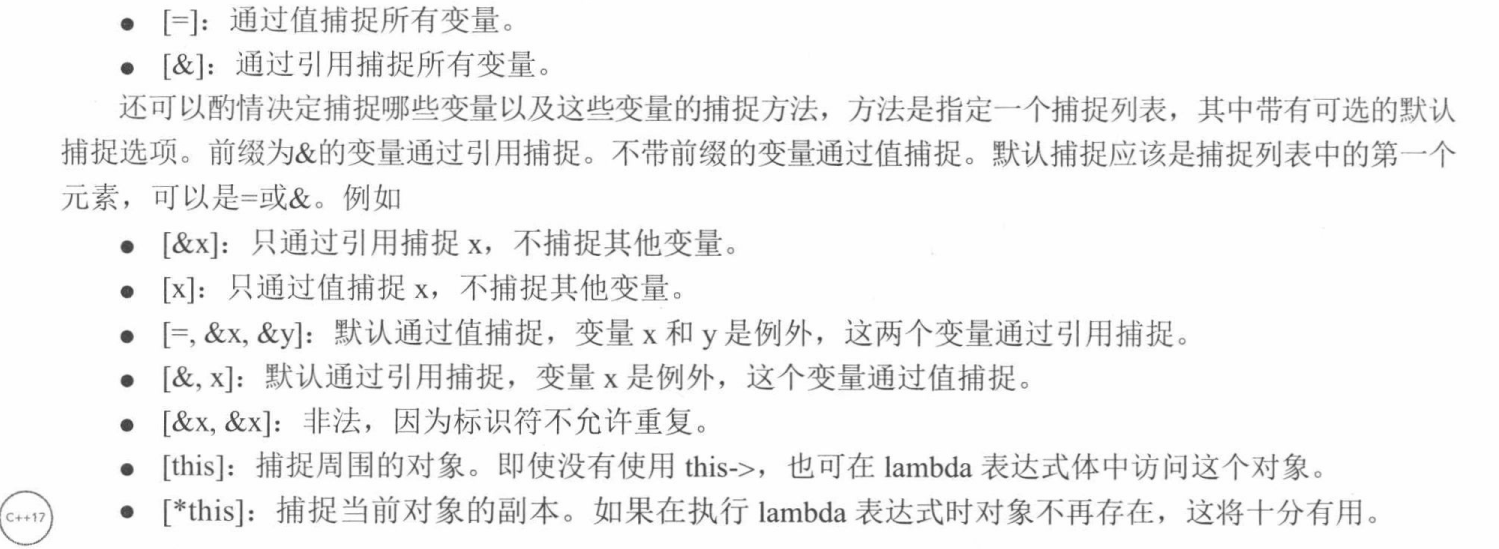
使用默认捕捉时,只有在 lambda 表达式体中真正使用的变量才会被捕捉,使用值(=)或引用(&)捕捉。未使用的变量不捕捉。
警告:不建议使用默认捕捉,即使只捕捉在 lambda 表达式体中真正使用的变量,也同样如此。使用 = 默认捕捉可能在无意中引发昂贵的复制。使用 & 默认捕捉可能在无意间修改所在作用域内的变量。建议显式指定要捕捉的变量。
泛型 lambda 表达式
可以给 lambda 表达式的参数使用自动推断类型功能,而无须显式指定它们的具体类型。要为参数使用自动推断类型功能,只需要将类型指定为 auto,类型推断规则与模板参数推断规则相同。
lambda 捕捉表达式
lambda 捕捉表达式允许用任何类型的表达式初始化捕捉变量。这可用于在 lambda 表达式中引入根本不在其内部的作用域内捕捉的变量:
double pi = 3.1415;
auto myLambda = [myCapture = "pi:", pi]{ cout << myCapture << pi; };

auto myPtr = std::make_unique<double>(3.1415);
auto myLambda = [p = std::move(myPtr)]{ cout << *p; };

// 捕捉变量允许使用与所在作用域相同的名称
auto myLambda = [myPtr = std::move(myPtr)]{ cout << *p; };
lambda 可作为函数返回值,返回类型为 function。还可以作为函数参数,参数类型为 function。
函数对象
在类中,可重载函数调用运算符(),使类的对象可取代函数指针。将这些对象称为函数对象(function object),或称为仿函数(functor)。
函数对象适配器
绑定器
绑定器(binder)可用于将函数的参数绑定至特定的值。为此要使用 <functional> 头文件中定义的 std::bind,它允许采用灵活的方式绑定可调用的参数。既可将函数的参数绑定至固定值,甚至还能重新安排函数参数的顺序。
假定有一个 func 函数,它接收两个参数:
void func(int num, string_view str) {
    cout << "func(" << num << ", " << str << ")" << endl;
}
通过 bind 将 func 函数的第二个参数绑定至固定值 myString。没有绑定至指定值的参数应该标记为 _1、_2 和 _3 等。这些都定义在 std::placeholders 名称空间中。
string myString = "abc";
auto f1 = bind(func, placeholders::_1, myString);
f1(16); // 输出: func(16, abc)
bind 还可用于重新排列参数的顺序:
auto f2 = bind(func, placeholders::_2, placeholders::_1);
f2("Test", 32); // 输出: func(32, Test)
修改序列算法
从一个范围向另一个范围复制元素、删除元素以及反转某个范围内元素的顺序。
警告:修改算法不能将元素插入目标范围中,仅可重写/修改目标范围中已经存在的元素。使用迭代器适配器,在目标范围中真正插入元素。
map 和 multimap 的范围不能用作修改算法的目标范围。这些算法改写全部元素,而在 map 中,元素是键值对。map 和 multimap 将键标记为 const,因此不能为其赋值。set 和 multiset 也是如此。替换方案是使用插入迭代器。
转换
transform
transform 算法对范围内的每个元素应用回调,期望回调生成一个新元素,并保存在指定的目标范围中。如果希望 transform 将范围内的每个元素替换为调用回调产生的结果,那么源范围和目标范围可以是同一范围。
// 将 vector 中的每个元素增加 100
transform(begin(myVector), end(myVector), begin(myVector),
    [](int i){ return i + 100; });
transform 的另一种形式对范围内的元素对调用二元函数,需要将第一个范围的首尾迭代器、第二个范围的首迭代器以及目标范围的首迭代器作为参数。
// vec2 的大小应该 >= vec1
transform(begin(vec1), end(vec1), begin(vec2), begin(vec1),
[](int a, int b){ return a + b; });注意:transform 和其他修改算法通常返回一个引用目标范围内最后一个值后面那个位置的迭代器。
复制
copy 算法可将一个范围内的元素复制到另一个范围,从这个范围内的第一个元素开始直到最后一个元素。源范围和目标范围必须不同,但在一定限制条件下可以重叠。
限制条件:对于 copy(b, e, d),如果 d 在 b 之前,则可以重叠;但如果 d 处于 [b, e] 范围,则行为不确定。
vector<int> vec1, vec2;
populateContainer(vec1);
vec2.resize(size(vec1)); // 以确保目标范围有足够空间
copy(cbegin(vec1), cend(vec1), begin(vec2));
copy_backward 算法将源范围内的元素反向复制到目标范围。这个算法从源范围的最后一个元素开始,将这个元素放在目标范围的最后一个位置,然后在每一次复制之后反向移动。
copy_if 算法需要提供由两个迭代器指定的输入范围、由一个迭代器指定的输出范围以及一个谓词。该算法将满足谓词的所有元素复制到目标范围。
vector<int> vec1, vec2;
populateContainer(vec1);
vec2.resize(size(vec1));
auto endIterator = copy_if(cbegin(vec1), cend(vec1),
    begin(vec2), [](int i){ return i % 2 == 0; });
vec2.erase(endIterator, end(vec2));
copy_n 从源范围复制 n 个元素到目标范围。
cnt = min(cnt, size(vec1));
vec2.resize(cnt);
copy_n(cbegin(vec1), cnt, begin(vec2));
移动
move 基于移动语义。如果要在自定义类型元素的容器中使用这两个算法,那么需要在元素类中提供移动赋值运算符 operator=(Class&& rhs)。
vector<MyClass> vecSrc{MyClass("a"), MyClass("b"), MyClass("c")};
vector<MyClass> vecDst(vecSrc.size());
move(begin(vecSrc), end(vecSrc), begin(vecDst));注意:在移动操作中,源对象将处于有效但不确定的状态。在执行移动操作后,不应该再使用 vecSrc 中的元素了,除非使它们重回确定状态。
替换
replace 和 replace_if 算法将一个范围内匹配某个值或满足某个谓词的元素替换为新的值。
replace_if(begin(vec), end(vec), [](int i){ return i % 2 != 0; }, 0);删除
假设要将某个范围内满足某特定条件的元素删除。一个简单的方法是遍历所有元素,并对每个满足条件的元素调用 erase。然而,如果对 vector 容器应用 erase,这个方法的效率非常低下,时间复杂度 O(n²)。
推荐的方法是”删除-擦除法”(remove-erase-idiom),只需要线性时间。算法只能访问迭代器抽象,不能访问容器。因此删除算法不能真正地从底层容器中删除元素,而是将匹配给定值或谓词的元素替换为下一个不匹配给定值或谓词的元素。返回的迭代器指向要删除的元素范围内的第一个元素。
void removeEmptyStrings(vector<string>& strings) {
    auto it = remove_if(begin(strings), end(strings),
        [](const string& str){ return str.empty(); });
    // 擦除移除的元素
    strings.erase(it, end(strings)); // [it, end)
}注意:remove 函数系列是稳定的,因为这些函数保持了容器中剩余元素的顺序。
唯一化
unique 算法是特殊的 remove,能将所有重复的连续元素删除。list 容器提供了自己的具有同样语义的 unique 方法。通常情况下应该对有序序列使用 unique,但 unique 也能用于无序序列。
反转
reverse 算法反转某个范围内元素的顺序。将范围内的第一个元素和最后一个元素交换,将第二个元素和倒数第二个元素交换,依此类推。
还有一个名为 reverse_copy 的版本,这个版本将结果复制到新的目标范围。
操作算法
for_each 和 for_each_n 对范围内的每个元素执行回调。
map<int, int> myMap = {{4, 40}, {5, 50}, {6, 60}};
for_each(cbegin(myMap), cend(myMap), [](const auto& p) {
    cout << p.first << "->" << p.second << endl;
});
利用 lambda 计算和与积:
vector<int> myVector {.....};
int sum = 0;
int product = 1;
for_each(cbegin(myVector), cend(myVector),
    [&sum, &product](int i) {
        sum += i;
        product *= i;
    });
排序算法
sort 函数一般情况下在 O(N log N) 时间内对某个范围内的元素排序。将 sort 应用于一个范围之后,根据运算符 operator<,这个范围内的元素以非递减顺序排列。
sort(begin(vec), end(vec), greater<>()); // 非递增stable_sort 的变体能保持范围内相等元素的相对顺序。
还有 is_sorted 和 is_sorted_until:如果给定的范围是有序的,is_sorted 就返回 true,而 is_sorted_until 返回给定范围内的一个迭代器,该迭代器之前的所有元素都是有序的。
二分搜索算法
有几个搜索算法只用于有序序列或至少已分区的元素序列。这些算法有 binary_search、lower_bound、upper_bound 和 equal_range。
lower_bound 算法在有序范围内查找不小于(即大于或等于)给定值的第一个元素,经常用于在有序的 vector 中确定应将新值插入哪个位置,使 vector 依然有序。
auto iter = lower_bound(begin(vec), end(vec), num);
vec.insert(iter, num);
binary_search 算法以对数时间而不是线性时间搜索元素,如果在指定范围内找到这个值,这个算法返回 true,否则返回 false。
集合算法
集合算法可用于任意有序范围。
- includes:检查某个有序范围内的所有元素是否包含在另一个有序范围内
- set_union:并集
- set_intersection:交集
- set_difference:差集
- set_symmetric_difference:对称差集
注意:
- 务必确保结果范围足够大,以保存操作的结果
- 不能使用关联容器中的迭代器范围来保存结果
merge 算法可将两个排好序的范围归并在一起,并保持排好的顺序。复杂度为线性时间 O(M+N)。
最大最小算法
min 和 max 算法通过运算符 operator< 或用户提供的二元谓词比较两个或多个任意类型的元素,分别返回较小或较大元素的 const 引用。
max(x, y);
max({x1, x2, x3, x4});
auto [min1, max1] = minmax({x1, x2, x3, x4});
min_element(vec.begin(), vec.end());
std::clamp 是一个小型辅助函数,在 <algorithm> 中定义,clamp(lo, v, hi) 可用于确保值(v)在给定的最小值(lo)和最大值(hi)之间。
并行算法
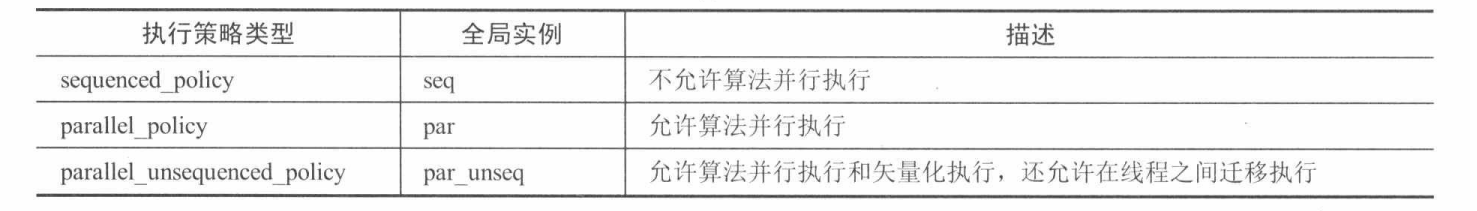
支持并行执行的算法包含选项,接收所谓的执行策略作为第一个参数。执行策略允许指定是否允许算法以并行方式或矢量方式执行。
sort(std::execution::par, begin(myVector), end(myVector));数值处理算法
inner_product
<numeric> 中定义的 inner_product 算法计算两个序列的内积:
vector<int> v1{1, 2, 3, 4};
vector<int> v2{9, 8, 7, 6};
cout << inner_product(cbegin(v1), cend(v1), cbegin(v2), 0) << endl;
// 输出 70: (1×9)+(2×8)+(3×7)+(4×6)
iota
<numeric> 头文件中定义的 iota 算法会生成指定范围内的序列值,从给定的值开始,并应用 operator++ 来生成每个后续值。
vector<int> vec(10);
iota(begin(vec), end(vec), 5);
for (auto& i : vec) cout << i << " ";
// 输出: 5 6 7 8 9 10 11 12 13 14
gcd 和 lcm
gcd 算法返回两个整数的最大公约数,而 lcm 算法返回两个整数的最小公倍数。
操作算法补充
关于 for_each 和 for_each_n,使用 lambda 或回调时,允许通过引用获得参数并对其进行修改,这样可以修改实际迭代器范围内的值。
for_each_n 算法需要范围的起始迭代器、要迭代的元素数量以及函数回调。它返回的迭代器等于 begin+n。它通常不执行任何边界检查。下例只迭代 map 的前两个元素:
for_each_n(cbegin(myMap), 2,
    [](const auto& p) {
        cout << p.first << "->" << p.second << endl;
    });
交换算法
-
std::swap(a,b):有效的交换两个值,并使用移动语义(如果可用的话)
-
std::exchange:定义在
<utility>头文件中,用新值替换旧值,并返回旧值。
exchange 用于实现移动赋值运算符。移动赋值运算符需要将数据从源对象移到目标对象。通常,源对象中的数据会变为 null。
Foo& operator=(Foo&& rhs) noexcept {
    // Check for self-assignment
    if (this == &rhs) { return *this; }
    // Free the old memory
    delete mPtr;
    mPtr = nullptr;
    // Move data from source to destination
    mPtr = rhs.mPtr;
    rhs.mPtr = nullptr; // Nullify data in source
    return *this;
}

// 对于方法底部的 mPtr 和 rhs.mPtr 的赋值,可使用 exchange 实现,如下所示:
Foo& operator=(Foo&& rhs) noexcept {
    // Check for self-assignment
    if (this == &rhs) { return *this; }
    // Free the old memory
    delete mPtr;
    mPtr = nullptr;
    // Move data
    mPtr = exchange(rhs.mPtr, nullptr); // Move + nullify
    return *this;
}
分区算法
partition_copy 算法将来自某个来源的元素复制到两个不同的目标范围。为每个元素选择特定目标的依据是谓词的结果:true 或 false,true 放第一个。partition_copy 的返回值是一对迭代器:一个迭代器引用第一个目标范围内最后复制的那个元素的后一个位置,另一个迭代器引用第二个目标范围内最后复制的那个元素的后一个位置。将这些返回的迭代器与 erase 结合使用,可删除两个目标范围内多余的元素。下例要求用户输入一些整数,然后将这些整数分区到两个目标 vector 中,一个保存偶数,另一个保存奇数。
vector<int> vec1, vecOdd, vecEven;
populateContainer(vec1);
vecOdd.resize(size(vec1)); // 保证有足够空间
vecEven.resize(size(vec1));
auto pairIters = partition_copy(cbegin(vec1), cend(vec1),
    begin(vecEven), begin(vecOdd),
    [](int i){ return i % 2 == 0; });
vecEven.erase(pairIters.first, end(vecEven)); // 删除两个目标范围内多余的元素
vecOdd.erase(pairIters.second, end(vecOdd));
partition 算法对序列排序,使谓词返回 true 的所有元素放在前面,使谓词返回 false 的所有元素放在后面,在每个分区中不保留元素最初的顺序。下例演示了如何把 vector 分为偶数在前、奇数在后的分区:
vector<int> vec;
populateContainer(vec);
partition(begin(vec), end(vec), [](int i){ return i % 2 == 0; });
排序算法补充
标准库提供了一些不同的排序算法。“排序算法”重新排列容器中元素的顺序,使集合中的元素保持连续顺序。因此,排序算法只能应用于顺序集合。**排序和有序关联容器无关,因为有序关联容器已经维护了元素的顺序。排序也和无序关联容器无关,因为无序关联容器就没有排序的概念。**一些容器(例如 list 和 forward_list)提供了自己的排序方法,因为这些方法内部实现的效率比通用排序机制的效率要高。
因此,通用的排序算法最适用于 vector、deque、array 和 C 风格数组。
并行算法补充
支持并行执行的算法包含选项,接收所谓的执行策略作为第一个参数。执行策略允许指定是否允许算法以并行方式或矢量方式执行。有三类标准执行策略,以及这些类型的三个全局实例,它们全部定义在 std::execution 名称空间的 <execution> 头文件中: