网络优化 - 构建足够快的网络服务
Categories: Network
参考:第二章: 构建”足够快”的网络服务 | 深入高可用系统原理与设计
了解各类延迟指标
| 操作 | 延迟 |
|---|---|
| CPU 从一级缓存中读取数据 | 1 ns |
| CPU 分支预测错误(Branch mispredict) | 3 ns |
| CPU 从二级缓存中读取数据 | 4 ns |
| 线性间互斥锁/解锁 | 17 ns |
| 在 1Gbps 的网络上发送 2KB 数据 | 44 ns |
| 访问一次主存 | 100 ns |
| 使用 Zippy 压缩 1KB 数据 | 2,000 ns ≈ 2 μs |
| 从内存顺序读取 1 MB 数据 | 3,000 ns ≈ 3 μs |
| 一次 SSD 随机读 | 16,000 ns ≈ 16 μs |
| 从 SSD 顺序读取 1 MB 数据 | 49,000 ns ≈ 49 μs |
| 一个数据包在同一个数据中心往返 | 500,000 ns ≈ 0.5 ms |
| 从磁盘顺序读取 1 MB 数据 | 825,000 ns ≈ 0.8 ms |
| 一次磁盘寻址 | 2,000,000 ns ≈ 2 ms |
| 一次 DNS 解析查询 | 50,000,000 ns ≈ 50 ms |
| 把一个数据包从美国发送到欧洲 | 150,000,000 ns ≈ 150 ms |
| 在宿主机中冷启动一个常规容器 | 5,000 ms ≈ 5 s |
HTTPS 请求优化分析
请求阶段分析
一个完整、未复用连接的 HTTPS 请求需要经过以下 5 个阶段:DNS 域名解析、TCP 三次握手、SSL 四次握手、服务器处理、内容传输。
这些阶段共需要 5 个 RTT(Round-Trip Time,往返时间)= 1 RTT(DNS Lookup,域名解析)+ 1 RTT(TCP Handshake,TCP 握手)+ 2 RTT(SSL Handshake,SSL 握手)+ 1 RTT(Data Transfer,HTTP 内容请求传输)。
各阶段耗时分析
HTTPS 请求的各个阶段可以使用 curl 命令进行详细的延迟分析。curl 命令提供了 -w 参数,该参数支持 curl 按照指定的格式打印与请求相关的信息,部分信息可以用特定的变量表示,例如 status_code、size_download、time_namelookup 等等。
$ cat curl-format.txt
    time_namelookup:  %{time_namelookup}\n
       time_connect:  %{time_connect}\n
    time_appconnect:  %{time_appconnect}\n
      time_redirect:  %{time_redirect}\n
   time_pretransfer:  %{time_pretransfer}\n
 time_starttransfer:  %{time_starttransfer}\n
                    ----------\n
time_total: %{time_total}\n| 变量名称 | 变量释义 |
|---|---|
| time_namelookup | 从请求开始到域名解析完成的耗时 |
| time_connect | 从请求开始到 TCP 三次握手完成的耗时 |
| time_appconnect | 从请求开始到 TLS 握手完成的耗时 |
| time_pretransfer | 从请求开始到向服务器发送第一个 GET/POST 请求开始之前的耗时 |
| time_redirect | 重定向耗时,包括到内容传输前的重定向的 DNS 解析、TCP 连接、内容传输等时间 |
| time_starttransfer | 从请求开始到内容传输前的耗时 |
| time_total | 从请求开始到完成的总耗时 |
$ curl -w "@curl-format.txt" -o /dev/null -s 'https://www.baidu.com/'
    time_namelookup:  0.003140
       time_connect:  0.031930
    time_appconnect:  0.132076
      time_redirect:  0.000000
   time_pretransfer:  0.132114
 time_starttransfer:  0.161962
                    ----------
         time_total:  0.162038
上述命令各个参数的意义是:
- -w:从文件中读取要打印信息的格式。
- -o /dev/null:把响应的内容丢弃。我们并不关心 HTTPS 的返回内容,只关心请求的耗时情况。
- -s:不输出请求的进度条。
注意 curl 打印的各个耗时都是从请求发起的那一刻开始计算,我们得将其转换成 HTTPS 各阶段耗时,例如域名解析耗时、TCP 建立耗时、TTFB 耗时等。
TTFB(Time To First Byte,首字节时间)指从浏览器请求页面到接收来自服务器发送的信息的第一个字节的时间。
HTTPS 的优化总结
了解 HTTPS 请求的各个阶段以及相应的延迟计算后,我们可以针对性地采取以下优化措施:
- 域名解析优化:减少域名解析产生的延迟。例如,提前获取域名解析结果备用,那么后续的 HTTPS 连接就能减少一个 RTT。
- 对传输内容进行压缩:传输数据的大小与耗时成正比,压缩传输内容是降低请求耗时最有效的手段之一。
- SSL 层优化:升级 TLS 算法和 HTTPS 证书,例如升级 TLS 1.3 协议,可将 SSL 握手的 RTT 从 2 个减少到 1 个。
- 传输层优化:升级拥塞控制算法以提高网络吞吐量。将默认的 Cubic 升级为 BBR 对于大带宽、长链路的弱网环境尤其有效。
- 网络层优化:使用商业化的网络加速服务,通过路由优化数据包,实现动态服务加速。
- 使用更现代的 HTTP 协议:升级至 HTTP/2,进一步升级到基于 QUIC 协议的 HTTP/3。
域名解析的原理与实践
域名解析的原理
域名是一种树状结构,最顶层的域名是根域名(注意是一个点”.”,它是 .root 的含义,不过现在”.root”已经默认被隐藏),然后是顶级域名(Top Level Domain,简写 TLD,例如 .com),再是二级域名(例如 google.com)
域名解析过程,其实就是从”域名树”的根部到底部,不断递归查询的过程:
- 第 1 步,用户向”DNS 解析器”(Recursive resolver)发出解析域名请求。“DNS 解析器”也称 LocalDNS,例如电信运营商的 114.114.114.114,谷歌的8.8.8.8。
- “DNS 解析器” 判断是否存在解析缓存:
- 存在,返回缓存的结果,也就是直接执行第 8 步;
- 不存在,执行第 2 步,向就近的”根域名服务器”查询域名所属”顶级域名服务器”,顶级域名服务器维护着域名托管、权威域名服务器的信息。
- 获取顶级域名服务器后,执行第 4 步,向该服务器查询”权威域名服务器”(Authoritative nameserver)。
- 获取”权威域名服务器”后,执行第 6 步,向该服务器查询域名的具体解析记录。
- “DNS 解析器” 获取到解析记录后,再转发给客户端(第 8 步),整个解析过程结束。
回顾整个解析过程,有 2 个环节容易出现问题:
- “DNS 解析器”是客户端与”权威域名服务器”的中间人,容易出现解析污染或者”DNS 解析器”宕机,这种情况会导致域名解析局部不可用;
- “权威域名服务器”出现故障,这种情况会导致域名解析全局不可用,但出现故障的概率极低。
域名解析故障时排查
如果请求一个 HTTPS 接口,出现服务不可用、Unknown host 等错误时,除了用 ping 测试连通性外,我们可以用 nslookup 或者 dig 命令确认域名解析是否出现问题。
nslookup 命令,该命令可用于查询域名的解析结果,判断域名解析是否正常。
nslookup baidu.com
;; Got recursion not available from 172.31.208.1
Server:         172.31.208.1
Address:        172.31.208.1#53

Non-authoritative answer:
Name:   baidu.com
Address: 39.156.66.10
Name:   baidu.com
Address: 110.242.68.66- 第一段的 Server 为当前使用的”DNS 解析器”
- 第二段的 Non-authoritative answer 意思是:因为”DNS 解析器”是转发”权威域名服务器”的记录,所以解析结果为非权威应答。可以看到域名和对应的ip地址。
实际上,“DNS 解析器”也经常出现问题,这时候再使用 nslookup 命令就不行了。
当怀疑系统默认的”DNS 解析器”异常时,我们可以使用 dig 命令,通过切换不同的”DNS 解析器”,分析解析哪里出现异常。例如,使用 8.8.8.8 查询 baidu.com 的解析记录。
dig @8.8.8.8 baidu.com

; <<>> DiG 9.18.28-0ubuntu0.22.04.1-Ubuntu <<>> @8.8.8.8 baidu.com
; (1 server found)
;; global options: +cmd
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 6226
;; flags: qr rd ra; QUERY: 1, ANSWER: 2, AUTHORITY: 0, ADDITIONAL: 1

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags:; udp: 512
;; QUESTION SECTION:
;baidu.com.                     IN      A

;; ANSWER SECTION:
baidu.com.              464     IN      A       39.156.66.10
baidu.com.              464     IN      A       110.242.68.66

;; Query time: 40 msec
;; SERVER: 8.8.8.8#53(8.8.8.8) (UDP)
;; WHEN: Mon Dec 02 15:31:01 CST 2024
;; MSG SIZE rcvd: 70- 第一段 opcode 为 QUERY,表示执行查询操作,status 为 NOERROR,表示解析成功, SERVFAIL表示解析失败。
- 第二段 QUESTION SECTION 部分显示了发起的 DNS 请求参数,A 表示我们默认查询 A 类型记录。
- 第三段 ANSWER SECTION 部分为 DNS 查询结果。
- 最后一段为查询所用的”DNS 解析器”、域名解析的耗时等信息。
如果使用 dig 排查各个公共”DNS 解析器”,全部出现 SERVFAIL 错误,这说明是”权威域名服务器”出现了问题。
HTTPDNS 解决”中间商”问题
“域名解析器”很容易出现域名劫持、解析时间过长、解析调度不精准等问题。这些问题的根源在于 域名解析经历了过多的中间环节,服务质量不可控。为了解决上述问题,一种新型的 DNS 解析模式 —— HTTPDNS 应运而生。
HTTPDNS 的工作原理:客户端内部集成 HTTPDNS 模块,跳过”操作系统定义的解析服务”(图中的 LocalDNS,也就是默认基于 UDP 协议的域名解析系统),替换为使用 HTTPS 协议请求更可靠的”软件定义的解析服务”。
软件定义的解析服务直接从”权威域名服务器”同步解析记录,逻辑更可控,也能准确判断客户端地区和运营商,得到更精准的解析结果。
对传输内容进行压缩
对传输内容进行压缩是提升 HTTP 服务可用性的关键手段。如使用 Gzip 压缩后,一个 100KB 的文件通常会减少到 30KB,体积降低 70%。这不仅提高了网络传输效率,还能减少带宽成本。
所有现代浏览器、客户端和 HTTP 服务器软件都支持压缩技术。压缩算法的选择通过 HTTP 客户端和服务器之间的协商机制确定:
- 首先,HTTP 客户端发送 Accept-Encoding 头部,其中列出它支持的压缩算法及其优先级;
- 服务器则从中选择一种兼容的算法对响应主体进行压缩,并通过 Content-Encoding 首部告知客户端所选的压缩算法。
默认情况下,一般使用 Gzip 对内容进行压缩,但针对 HTTP 类型的文本内容还有一个更高压缩率的算法 Brotli。Brotli 是 Google 推出的开源无损压缩算法
在服务端安装了 Brotli 模块(如 ngx_brotli)后,可以与 gzip 一同启用,以最大化兼容性。以下是 Nginx 中启用 Brotli 的配置示例:
http {
	brotli on; // 开启 brotli 压缩
    brotli_comp_level 6;  // 设置压缩等级
    brotli_buffers 16 8k; // 设置缓冲的数量和大小
    brotli_min_length 20; // 压缩的最小长度
    brotli_types text/plain text/css application/json application/x-javascript text/xml application/xml application/xml+rss text/javascript application/javascript image/svg+xml; // 压缩类型

    // gzip 配置
    ...
}
HTTPS 加密原理
因为 HTTP 的内容是明文传输的,明文数据经过中间代理服务器、路由器、WIFI 热点、通信服务运营商节点时,如果信息在传输过程中被劫持,传输的内容就完全暴露了。劫持者还可以篡改传输的信息且不被双方察觉,这就是中间人攻击(Man-in-the-middle attack,缩写:MITM)。所以我们才需要对信息进行加密。
- 对称加密:加密和解密的过程可以使用一个密钥(Share key)作为参数,密钥必须保密,但加密和解密的过程可以公开。只要密钥不被中间人获取,两方通信的机密性就能得到保证。
- 非对称加密:两把密钥,一把叫做公钥(Public Key),可以向公众开放。另一把叫私钥或密钥(Private Key),私钥是必须保密的。用公钥加密的内容必须用私钥才能解开,私钥加密的内容只有公钥能解开。
非对称加密算法通常需要更多的计算资源,尤其在加密或解密大量数据时计算消耗更大。因此,我们使用计算效率更高的对称加密算法来加密 HTTP 内容,非对称加密算法来加密对称加密的密钥。
数字证书
网站在使用 HTTPS 前,需要向 CA 机构申领一份数字证书,数字证书里含有证书持有者、域名、公钥、过期时间等信息。服务器把证书传输给浏览器,浏览器从证书里获取公钥就行了。
数字证书就如身份证,证明”该公钥对应该网站”。而这里又有一个显而易见的问题:“证书本身的传输过程中,如何防止被篡改?“,即如何证明证书本身的真实性。
我们把证书原本的内容生成一份”签名”,比对证书内容和签名是否一致就能判别是否被篡改。这里的”签名”就叫数字签名。
- CA 机构拥有非对称加密的私钥和公钥。
- CA 机构对证书明文数据进行hash。
- 对 hash 后的值用私钥加密,得到数字签名 S。
明文和数字签名共同组成了数字证书,这样一份数字证书就可以颁发给网站了。
假设中间人篡改了证书的原文,由于他没有 CA 机构的私钥,所以无法得到修改后证书的对应的数字签名。浏览器收到该证书后会发现原文和签名解密后的值不一致,则说明证书已被篡改,证书不可信,从而终止向服务器传输信息,防止信息泄露给中间人。且如果中间人用自己的私钥对篡改后的证书进行数字签名,浏览器收到后用CA的公钥进行解密和对比计算结果,任然可以得到证书不可信。
RSA 握手过程
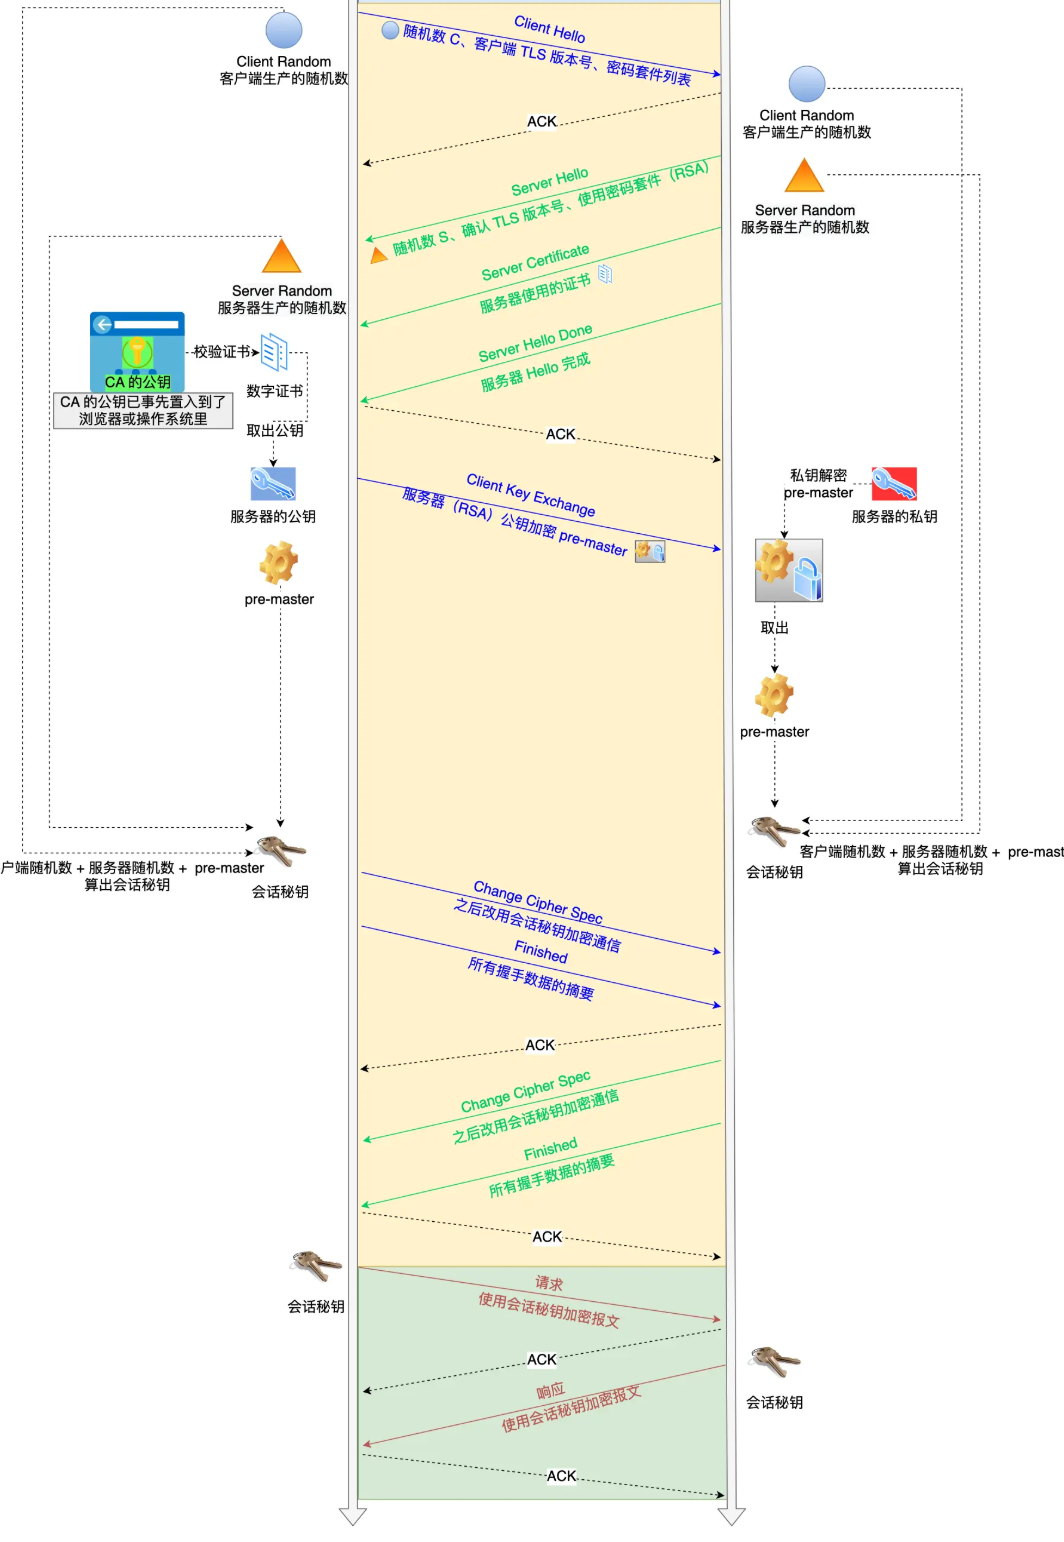
- 客户端Hello(Client Hello)
客户端发起SSL/TLS连接请求时,会发送一个 Client Hello 消息给服务器,包含以下内容:
- 客户端支持的SSL/TLS版本:例如TLS 1.2、TLS 1.3等
- 支持的加密套件(Cipher Suites):客户端会列出自己支持的加密算法集合
- 客户端随机数(Client Random):用于后续的密钥生成过程
- 扩展信息:如支持的压缩算法、SNI等
- 服务器Hello(Server Hello)
服务器收到 Client Hello 后,会选择其中一个加密套件和协议版本,并返回一个 Server Hello 消息给客户端,包含:
- 服务器选定的SSL/TLS版本
- 服务器选定的加密套件
- 服务器随机数(Server Random)
- 服务器证书:包含公钥,用于身份验证
- 服务器身份验证与密钥交换
- 证书验证:客户端使用服务器提供的证书来验证服务器的身份
- 密钥交换:客户端生成一个预主密钥(Pre-Master Secret),并使用服务器的公钥加密后发送给服务器。服务器使用其私钥解密得到预主密钥
- 客户端完成(Client Finished)
客户端发送 Finished 消息,使用会话密钥对前面所有消息的摘要(哈希)进行加密并发送。
- 服务器完成(Server Finished)
服务器收到客户端的 Finished 消息后,会验证客户端的消息认证码,确保握手过程中没有数据被篡改。然后,服务器也会发送 Finished 消息给客户端。
- 安全数据传输
在SSL/TLS握手完成后,客户端和服务器使用 对称加密(如AES)加密通信数据。
HTTPS 优化方案
使用 TLS1.3 协议
2018 年发布的 TLS 1.3 协议优化了 SSL 握手过程,将握手时间缩短至 1 次 RTT。如果复用之前的连接,甚至可以实现 0 RTT(通过使用 early_data 扩展)。
使用 ECC 证书
HTTPS 数字证书分为 RSA 证书和 ECC 证书,二者的区别在于:
- RSA 证书采用 RSA 算法生成公钥,具有良好的兼容性,但不支持完美前向保密(PFS)。PFS 能确保即使私钥泄露,也无法破解泄露之前的通信内容。
- ECC 证书则使用椭圆曲线加密算法(Elliptic Curve Cryptography)生成公钥,具有较快的计算速度和更高的安全性,且支持 PFS。
从 Nginx 1.11.0 开始,支持配置 RSA/ECC 双证书。
调整 HTTPS 会话缓存
HTTPS 连接建立后,会生成一个会话(session),用于保存客户端和服务器之间的安全连接信息。如果会话未过期,后续连接可以复用之前的握手结果,从而提高连接效率。
开启 OCSP stapling
客户端首次下载数字证书时,会向 CA 发起 OCSP(在线证书状态协议)请求,以验证证书是否被撤销或过期。
OCSP Stapling 技术将客户端本地的 OCSP 查询工作转交给后端服务器处理。后端服务器会预先获取并缓存 OCSP 响应,从而避免了客户端本地验证证书时可能遇到的网络延迟问题。
HTTPS 配置推荐使用 TLS1.3 协议 + ECC 证书方式。
网络拥塞控制
网络拥塞控制原理
网络吞吐效率与 RTT 和传输速率密切相关:
- RTT 越低,数据传输的延迟越短;
- 传输速率越高,网络在单位时间内处理的数据越多。
关键概念:
- RTprop (Round-Trip propagation time,两个节点之间最小时延):取决于物理距离
- BtlBw(Bottleneck Bandwidth,瓶颈带宽):网络链路中最窄处的带宽
- BDP(Bandwidth-Delay Product,带宽和延迟的乘积):代表了网络上能够同时容纳的数据量。BDP = 带宽 × 延迟
- inflight 数据:指已经发送出去但尚未收到确认的数据包
早期拥塞控制
早期互联网的拥塞控制以丢包为控制条件。发送方维护一个拥塞窗口 cwnd:
- 慢启动(Slow Start)阶段:慢慢增大拥塞控制窗口
- 拥塞避免(Congestion Avoidance)阶段:出现丢包时减小拥塞控制窗口
- 当丢包不再出现时,再次进入慢启动阶段
现代拥塞控制 - BBR
BBR 的目标是充分利用链路带宽和路由/网关设备的缓存队列,最大化网络效能。
最大化网络效能的前提是找到网络传输中的最优点:
- min RTT(延迟极小值):此时,网络中路由/网关设备的 Buffer 未占满,没有任何丢包情况
- max BW(带宽极大值):此时,网络中路由/网关设备的 Buffer 被充分利用
BBR 的设计原理
BBR 不再考虑丢包作为拥塞的判断条件,而是交替测量带宽和延迟。BBR 的拥塞控制状态机包含四种状态:
- 启动阶段(STARTUP):连接建立时,指数级提升发送速率,尽快找到最大带宽
- 排空阶段(DRAIN):通过指数级降低发送速率,清空缓冲区中的多余数据包
- 带宽探测阶段(PROBE_BW):BBR 主要运行的状态,以稳定的速率维持网络状态
- 时延探测阶段(PROBE_RTT):如果未检测到更小的最小 RTT,则进入该阶段重新测量
BBR 的应用
Linux 内核从 4.9 开始集成了 BBR 拥塞控制算法。
查询系统所支持的拥塞控制算法:
$ sysctl net.ipv4.tcp_available_congestion_control
net.ipv4.tcp_congestion_control = bbr cubic reno
查询当前使用的拥塞控制算法:
$ sysctl net.ipv4.tcp_congestion_control
net.ipv4.tcp_congestion_control = cubic
指定拥塞控制算法为 bbr:
$ echo net.ipv4.tcp_congestion_control=bbr >> /etc/sysctl.conf && sysctl -p网络拥塞控制是单向生效,也就是说作为下行方的服务端调整了,BBR 算法即可生效。
对请求进行”动态加速”
区别于静态文件缓存技术 CDN,“动态加速”DCDN并非依赖”边缘节点”中的缓存数据,而是利用”边缉节点”优化 IP 路由和传输层实现网络加速。
主流的技术服务商在全球多个地区部署了数量庞大的边缘服务器,构建了一个庞大的全球性加速网络。操作流程大致如下:
- 源站(Origin)将域名 CNAME 到 CDN 服务商提供的域名
- 源站提供一个用于测试网络质量的文件资源
- 服务商在源站周边选择一批候选的转发节点(Relay Node)
- 转发节点对测试资源进行下载测试,多个转发节点多路探索后,根据丢包率、RTT、路由的 hops 数等,选择出一条客户端到源站之间的最佳路径
QUIC 协议
QUIC 出现的背景
作为四十年前开发的传输层通信协议,TCP 在当今复杂的移动网络环境中存在先天的设计缺陷:
- 建立连接时握手延迟大:HTTPS 初次连接(TCP 握手 + TLS 握手)至少需要 3 个 RTT
- 队头阻塞问题:多个数据请求在同一个 TCP 连接上必须按顺序依次传输
- TCP 协议僵化问题:许多中间设备已经依赖某些隐式规则,推动 TCP 协议更新脱离现实
QUIC 的特点
QUIC(Quick UDP Internet Connection)是一种基于 UDP 封装的安全可靠传输协议。
支持连接迁移
QUIC 使用 Connection ID 标识连接,当源地址发生改变时,连接不受环境变化影响,因此 QUIC 可以实现网络变化的无缝切换。
低时延连接
QUIC 初次连接只需要 1-RTT 就能开启数据传输,而 TLS 1.3 初次连接也至少需要 2-RTT。
可插拔拥塞控制
大多数 QUIC 实现工作在用户空间,支持灵活”插拔”不同的拥塞控制算法,如 Cubic、BBR 和 PCC 等。
降低对丢包的敏感度
QUIC 为每个 Stream 设计了独立的控制机制,Stream 之间没有顺序依赖。如果一个 UDP 数据包丢失,它只会影响对应的 Stream,不会阻塞其他 Stream 的传输,有效避免了 TCP 协议中的队头阻塞问题。
QUIC 确保了在当今网络环境中比 TCP 更安全、更快速的连接以及更高的传输效率。
综上所述,无论是服务端还是客户端,集成 QUIC 协议并非一件易事:
- 服务端层面:不仅需要适配 QUIC 协议,还要确保与 TCP 协议兼容
- 客户端层面:面临适配与收益之间的成本权衡。需要具备降级容错能力,并做好长时间同时维护新旧两种网络库的准备
对请求进行”动态加速”
区别于静态文件缓存技术 CDN,“动态加速”DCDN并非依赖”边缘节点”中的缓存数据,而是利用”边缘节点”优化 IP 路由和传输层实现网络加速。
目前,主流的技术服务商,如 Akamai、Fastly、Amazon CloudFront 和 Microsoft Azure 等在全球多个地区部署了数量庞大的边缘服务器,构建了一个庞大的全球性加速网络。使用上述服务商提供的”动态加速”操作简单,一般将域名的解析记录 CNAME 到服务商提供的域名后,整个加速过程就能自动实现。操作流程大致如下:
- 源站(Origin)将域名 CNAME 到 CDN 服务商提供的域名,例如将 www.thebyte.com.cn CNAME 到 thebyte.akamai.com
- 源站提供一个 20KB 左右的用于测试网络质量的文件资源
- 服务商在源站周边选择一批候选的转发节点(Relay Node)
- 转发节点对测试资源进行下载测试,多个转发节点多路探索后,根据丢包率、RTT、路由的 hops 数等,选择出一条客户端(End Users)到源站之间的最佳路径
DCDN是一种全站加速的解决方案_边缘安全加速(ESA)-阿里云帮助中心
QUIC 设计原理与实践
QUIC(Quick UDP Internet Connection,快速 UDP 网络连接)是一种基于 UDP 封装的安全可靠传输协议,旨在取代 TCP,成为新一代互联网的主流传输协议。
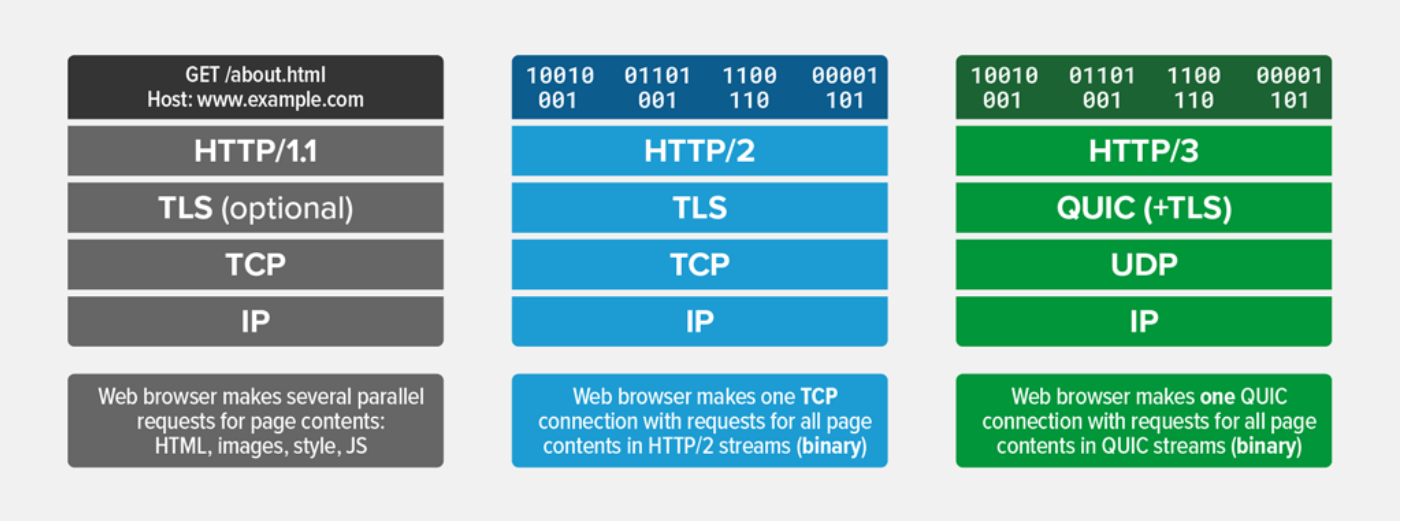
可以看出,HTTP/3 最大的特点是:底层基于 QUIC 协议,默认集成了 TLS 安全协议。
QUIC 出现的背景
作为四十年前开发的传输层通信协议,TCP 的设计者显然没有预见今天移动设备盛行的场景。在当今复杂的移动网络环境中,TCP 存在先天的设计缺陷,集中在以下几点:
- 建立连接时握手延迟大:HTTPS 初次连接(TCP 握手 + TLS 握手)至少需要 3 个 RTT 才能建立
- 队头阻塞问题:以 HTTP/2 为例,多个数据请求在同一个 TCP 连接上所有 stream(流,HTTP/2 传输的数据单元)必须按顺序依次传输。如果一个 stream 的数据丢失,后面其他的 stream 将被阻塞,直到丢失的数据被重传
- TCP 协议僵化问题:作为一个运行了接近 40 多年的协议,许多中间设备(如防火墙和路由器)已经变得依赖某些隐式规则,打补丁或者说推动 TCP 协议更新脱离现实
QUIC 的特点
QUIC 基于 UDP 实现了一种全新的可靠性传输机制,具有更低的延迟和更高的吞吐量。
支持连接迁移
当用户网络环境发生变化,这在移动端相当普遍,例如 WIFI 切换到 4G 时,TCP 基于四元组的方式无法保持连接的存活。而 QUIC 由于使用 Connection ID 标识连接,当源地址发生改变时,连接不受环境变化影响,因此 QUIC 可以实现网络变化的无缝切换,从而保证连接存活和数据正常收发。
低时延连接
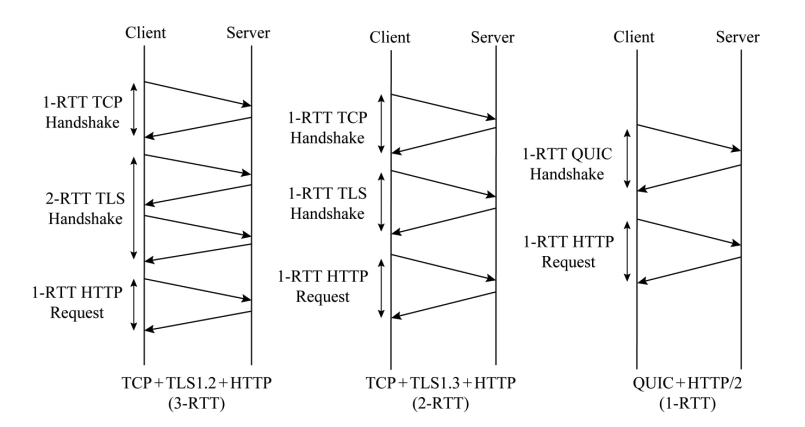
以 HTTPS 请求为例,即使是最新的 TLS 1.3 协议,初次连接也至少需要 2-RTT 才能开启数据传输。
QUIC 内部集成了 TLS 安全协议,无需像 TCP 先经过三次握手,再经过 TLS 握手才开启数据传输。QUIC 初次连接只需要 1-RTT 就能开启数据传输。
可插拔拥塞控制
大多数 QUIC 实现工作在用户空间,支持灵活”插拔”不同的拥塞控制算法,如 Cubic、BBR 和 PCC 等。无需深入内核开发的情况下,能灵活调整可靠传输机制和拥塞控制策略。如 Cloudflare 开发的开源 QUIC 实现 quiche,提供了 setSendAlgorithm 方法,工程师可直接选择合适的拥塞控制算法,无需经过操作系统内核。
降低对丢包的敏感度
先来看 HTTP/2 Stream 的处理。
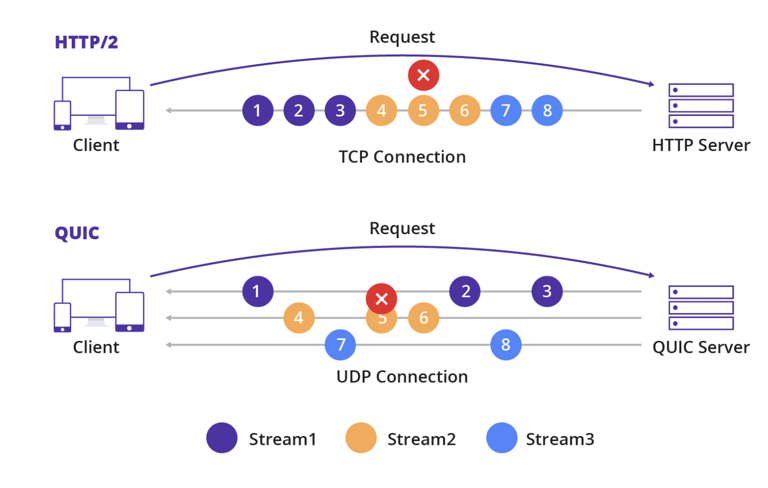
如图所示,若一个属于 Stream2 的 TCP 数据包丢失(如图中标记为 5 的圆圈),将导致后续数据包的传输阻塞。该问题就是业界常常提到的”队头阻塞”(head-of-line blocking)。
相比之下,QUIC 为每个 Stream 设计了独立的控制机制,Stream 之间没有顺序依赖。这意味着,如果一个属于 Stream2 的 UDP 数据包丢失,它只会影响 Stream2 的处理,不会阻塞 Stream1 和 Stream3 的传输。这样的设计有效避免了 TCP 协议中的队头阻塞问题。
QUIC 实现的另一个特性 —— QPACK。QPACK 通过更高效的头部压缩技术,减少了网络传输中的冗余数据量。这种压缩机制不仅提升了数据传输的效率,还能缓解前面提到的”队头阻塞”。
QUIC 确保了在当今网络环境中比 TCP 更安全、更快速的连接以及更高的传输效率。
综上所述,无论是服务端还是客户端,集成 QUIC 协议并非一件易事:
- 服务端层面:不仅需要适配 QUIC 协议,还要确保与 TCP 协议兼容。此外,TCP 经过多年的深度优化,引发了一个问题:“QUIC 在实际应用中的效能表现是否能够与 TCP 相媲美?”
- 客户端层面:面临适配与收益之间的成本权衡。采用 QUIC 协议的客户端需要具备降级容错能力,并做好长时间同时维护新旧两种网络库的准备
Linux 系统收包流程
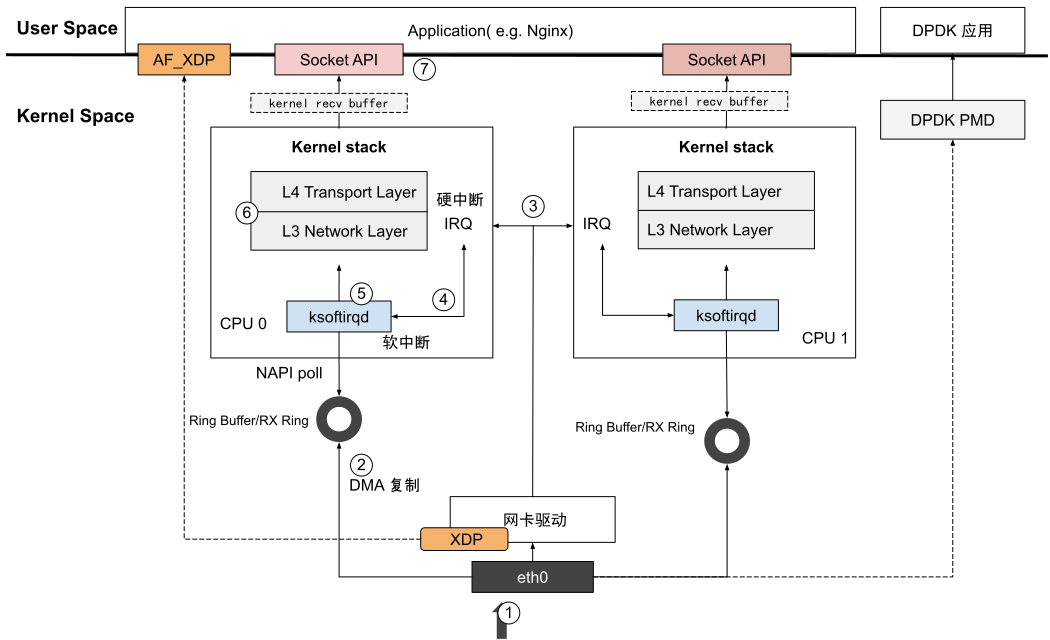
- 当外部网络发送数据包到服务器时,首先由网卡 eth0 接收该数据包
- 网卡通过 DMA(Direct Memory Access,直接内存访问)技术,将数据包直接拷贝到内核中的 RingBuffer(环形缓冲区)等待 CPU 处理。RingBuffer 是一种首尾相接的环形数据结构,它的主要作用是作为缓冲区,缓解网卡接收数据的速度快于 CPU 处理数据的速度问题
- 数据包成功写入 RingBuffer 后,网卡产生 IRQ(Interrupt Request,硬件中断),通知内核有新的数据包到达
- 内核收到硬件中断后,立即调用对应的中断处理函数。通常情况下,中断处理函数会简单地标记有新数据到达,并唤醒 ksoftirqd 内核线程来处理软中断(SoftIRQ)
- 软中断处理过程中。内核调用网卡驱动提前在内核中注册的 NAPI(New API)poll 接口,从 RingBuffer 中提取数据包,并生成 skb(Socket Buffer)数据。skb 是 Linux 内核中用于管理网络数据包的主要结构。它包含了网络包的所有信息,包括头部、数据负载等,并在内核的各个网络协议层之间传递
- skb 被传递到内核协议栈中进行处理。这里涉及多个网络层次的处理操作:
- 网络层(L3 Network layer):根据主机中的路由表,判断数据包路由到哪一个网络接口(Network Interface)。这里的网络接口可能是稍后介绍的虚拟设备,也可能是物理网卡 eth0 接口
- 传输层(L4 Transport layer):如解/封数据包,处理网络地址转换(NAT)、连接跟踪(conntrack)等操作
- 内核协议栈处理完成后,数据包被传递到 socket 接收缓冲区。应用程序随后利用系统调用(如 Socket API)从缓冲区中读取数据。至此,整个收包过程结束
分析 Linux 系统处理网络数据包的过程:数据包的处理流程过于冗长。整个处理流程涉及到多个网络层协议栈,如数据链路层、网络层、传输层和应用层。这些网络层之间传递数据需要封包/解包,以及频繁的操作系统上下文切换。